Anthropic의 Central Library로 본 기업 AI의 조건, AI-Ready Data
2026.10.15
한눈에 보는 핵심 인사이트Anthropic은 양질의 학습 데이터를 확보하기 위해 종이책 수백만 권을 사들여 스캔했습니다. AI 경쟁력이 데이터의 질에서 나온다는 판단이었습니다. 기업 AI도 다르지 않습니다. 가트너는 2026년까지 AI-Ready Data가 뒷받침되지 않는 AI 프로젝트의 60%가 중단될 것으로 전망했습니다. 기업에는 이미 외부에서 살 수 없는 고유한 데이터가 있습니다. 이 데이터를 AI가 바로 활용할 수 있는 형태로 연결하고, 구조화하고, 관리하는 일이 AI 성과의 출발점입니다. |
양질의 데이터를 위해 종이책까지 사들인 Anthropic
Claude를 개발한 Anthropic은 ‘세상의 모든 책’을 모아 Central Library를 만들고자 했습니다. 그 가운데 Project Panama는 종이책을 대량 구매해 책등을 잘라 스캔하고, 스캔을 마친 종이는 재활용 처리한 프로젝트입니다. 이 사실은 저작권 소송 과정에서 알려졌고, 미국 연방지방법원은 합법적으로 구매한 책을 디지털화해 AI 학습에 쓴 것은 공정 이용으로 판단했습니다.
판결문에 따르면 Anthropic은 책이 최고 수준의 LLM을 만드는 가장 비용 효율적인 수단이라고 판단했습니다. 책에는 편집 과정을 거친 완결된 문장과 일관된 맥락, 체계적인 지식이 담겨 있습니다. 품질이 들쭉날쭉한 웹 데이터보다 AI가 배우기 좋은 재료입니다. 최근 미국 시민단체들이 책을 대량 구매해 스캔한 뒤 폐기하는 관행을 조사해 달라고 연방거래위원회(FTC)에 요청할 만큼, 양질의 데이터 확보는 치열한 경쟁이 됐습니다.
기업 AI 프로젝트의 성패를 가르는 AI-Ready Data
기업이 AI를 도입할 때도 결과를 좌우하는 것은 데이터입니다. 가트너가 2024년 7월 데이터 관리 리더 1,203명을 조사한 결과, 응답 조직의 63%가 AI에 맞는 데이터 관리 체계를 갖추지 못했거나 갖췄는지 확신하지 못했습니다. 가트너는 2026년까지 AI-Ready Data가 뒷받침되지 않는 AI 프로젝트의 60%가 중단될 것으로 전망했습니다.
가트너는 AI-Ready Data의 요건이 기존 데이터 관리와 크게 다르다는 점을 인식하지 못하면 AI 성과가 위태로워진다고 경고합니다. 데이터에 문제가 있다면, 그 데이터는 AI에 쓸 준비가 되지 않은 것입니다. 뛰어난 모델을 도입해도 데이터가 흩어져 있거나 맥락 없이 쌓여 있다면 결과물의 품질은 높아지기 어렵습니다.
기업이 AI-Ready Data를 갖추기 위한 세 가지 조건
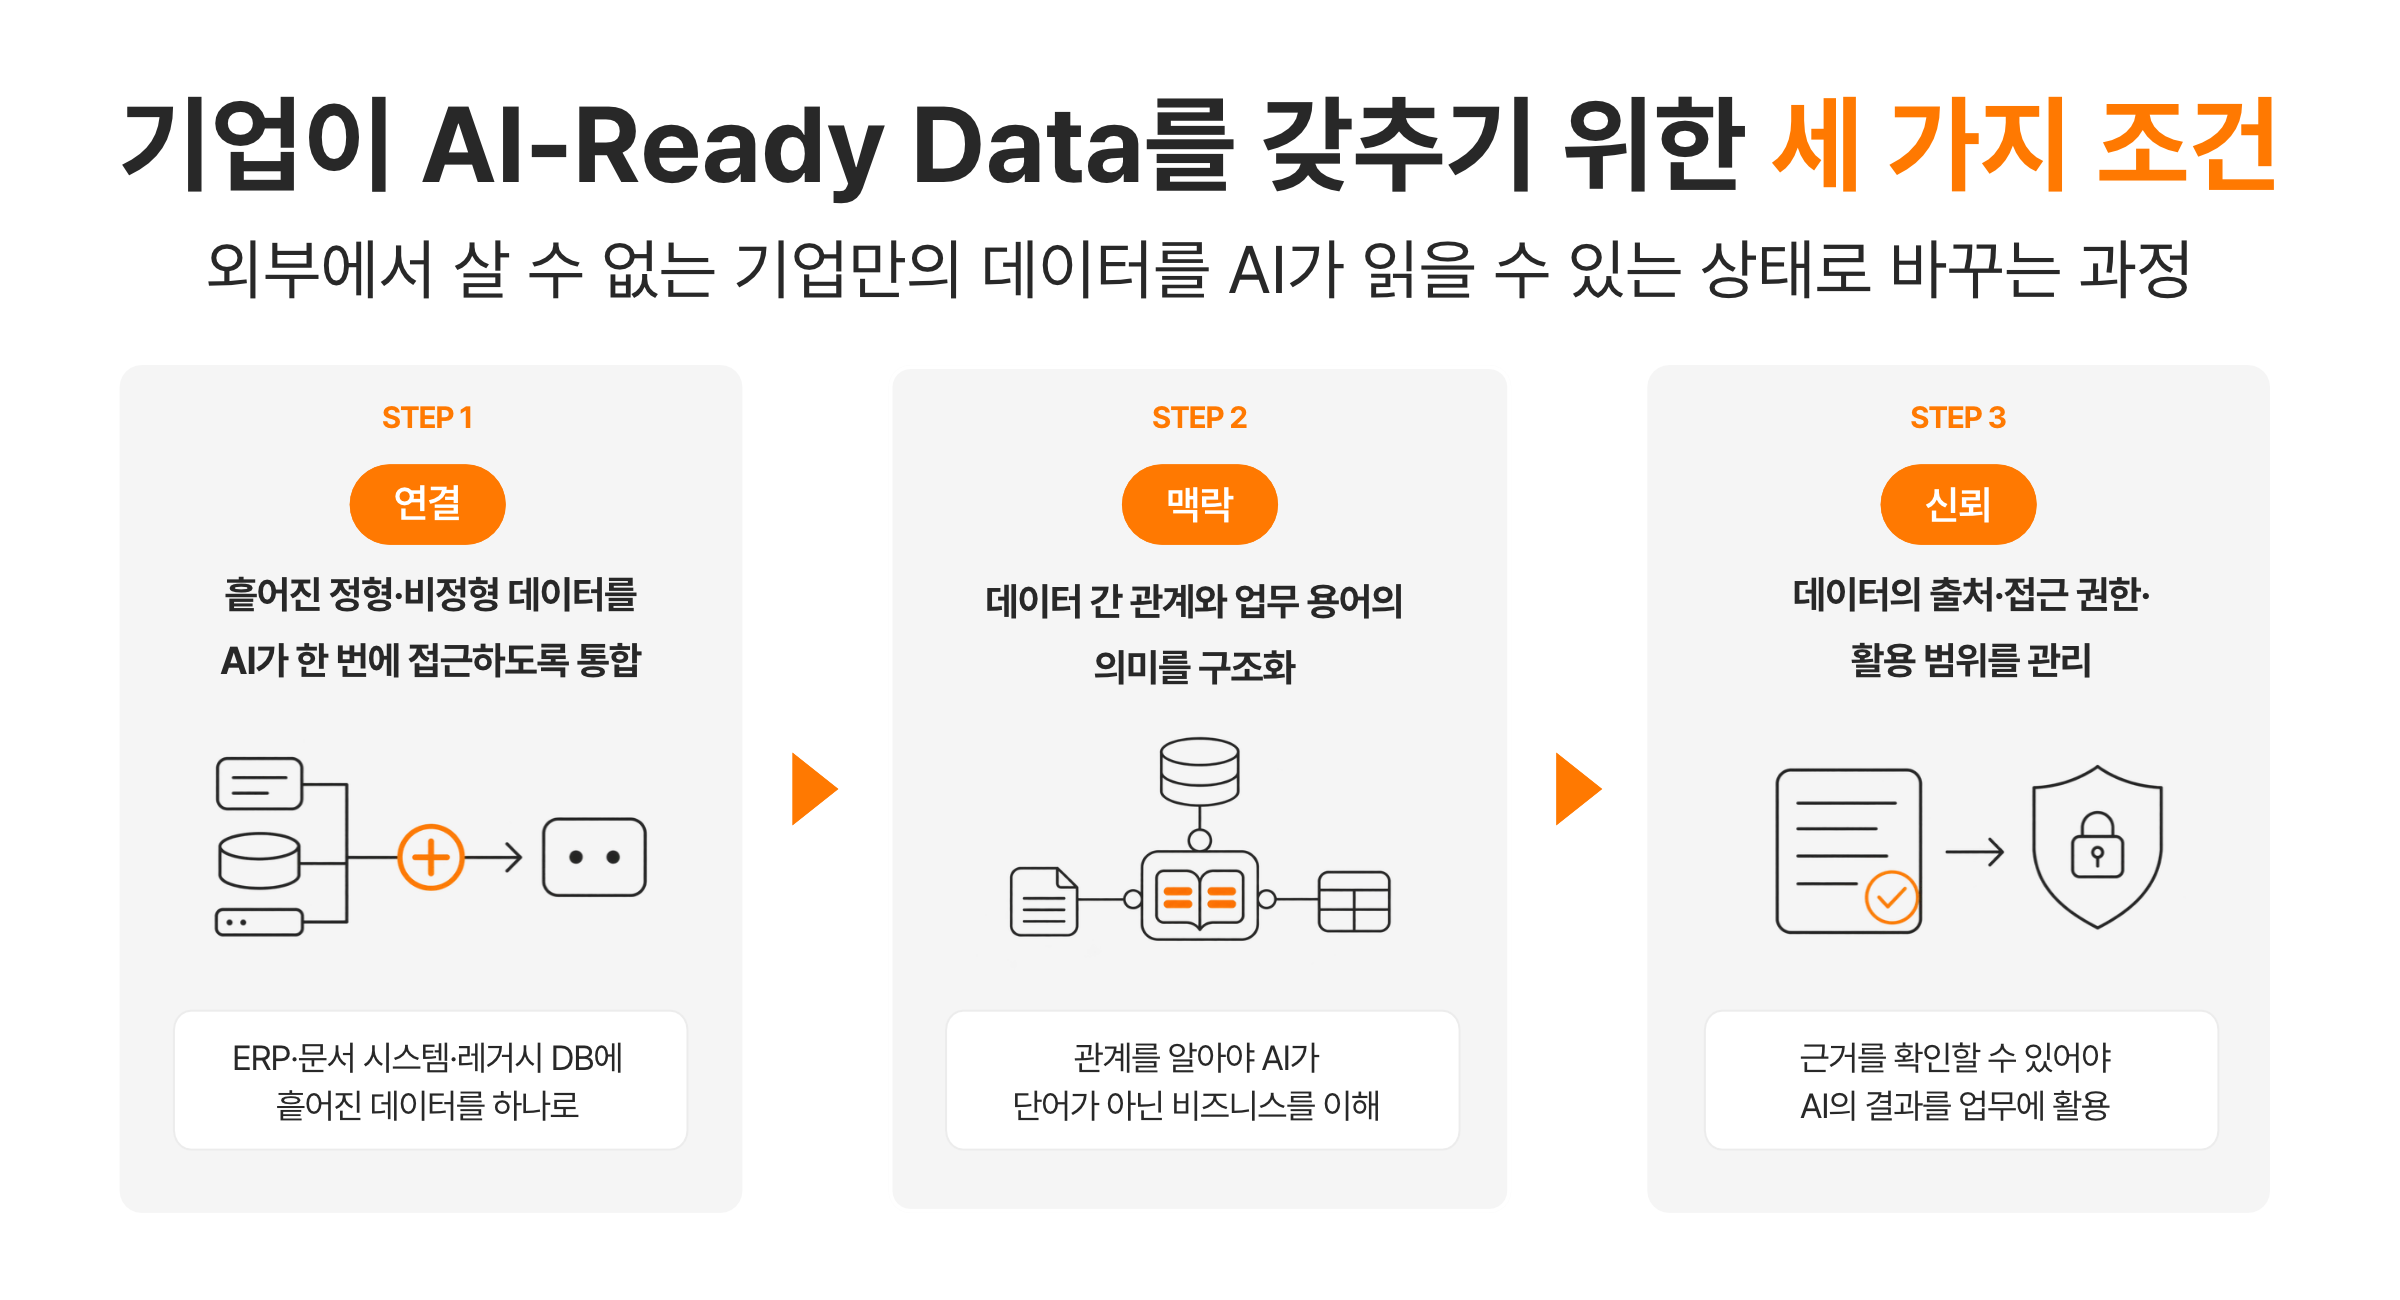
Anthropic이 책을 사들여야 했던 것과 달리, 기업에는 이미 고유한 데이터가 있습니다. 문서, 업무 지식, 고객 데이터처럼 외부에서 살 수 없는 그 기업만의 ‘책’입니다. 문제는 이 데이터가 AI가 읽을 수 있는 상태가 아니라는 데 있습니다. 이 데이터를 AI-Ready Data로 바꾸려면 세 가지가 필요합니다.
첫째는 연결입니다. 기업 데이터는 ERP, 문서 시스템, 레거시 DB에 흩어져 있어, AI가 필요한 정보의 일부만 보고 판단하기 쉽습니다. 흩어진 정형·비정형 데이터를 AI가 한 번에 접근할 수 있도록 묶어야 합니다.
둘째는 맥락입니다. 데이터가 한곳에 모여도 관계와 업무상 의미를 모르면, AI는 단어만 맞춘 답을 내놓습니다. 데이터 간 관계와 업무 용어의 의미를 구조화해야 AI가 비즈니스를 이해합니다.
셋째는 신뢰입니다. AI가 어떤 데이터를 근거로 답했는지 확인할 수 없다면 결과를 업무에 쓰기 어렵습니다. 데이터의 출처와 접근 권한, 활용 범위를 관리해야 AI의 결과를 믿고 쓸 수 있습니다.
세 조건은 차례로 쌓입니다. 연결되지 않은 데이터에는 맥락을 입힐 수 없고, 맥락 없는 데이터는 신뢰를 검증하기 어렵습니다.
AI-Ready Data 확보의 중심, SK AX AXgenticWire Core
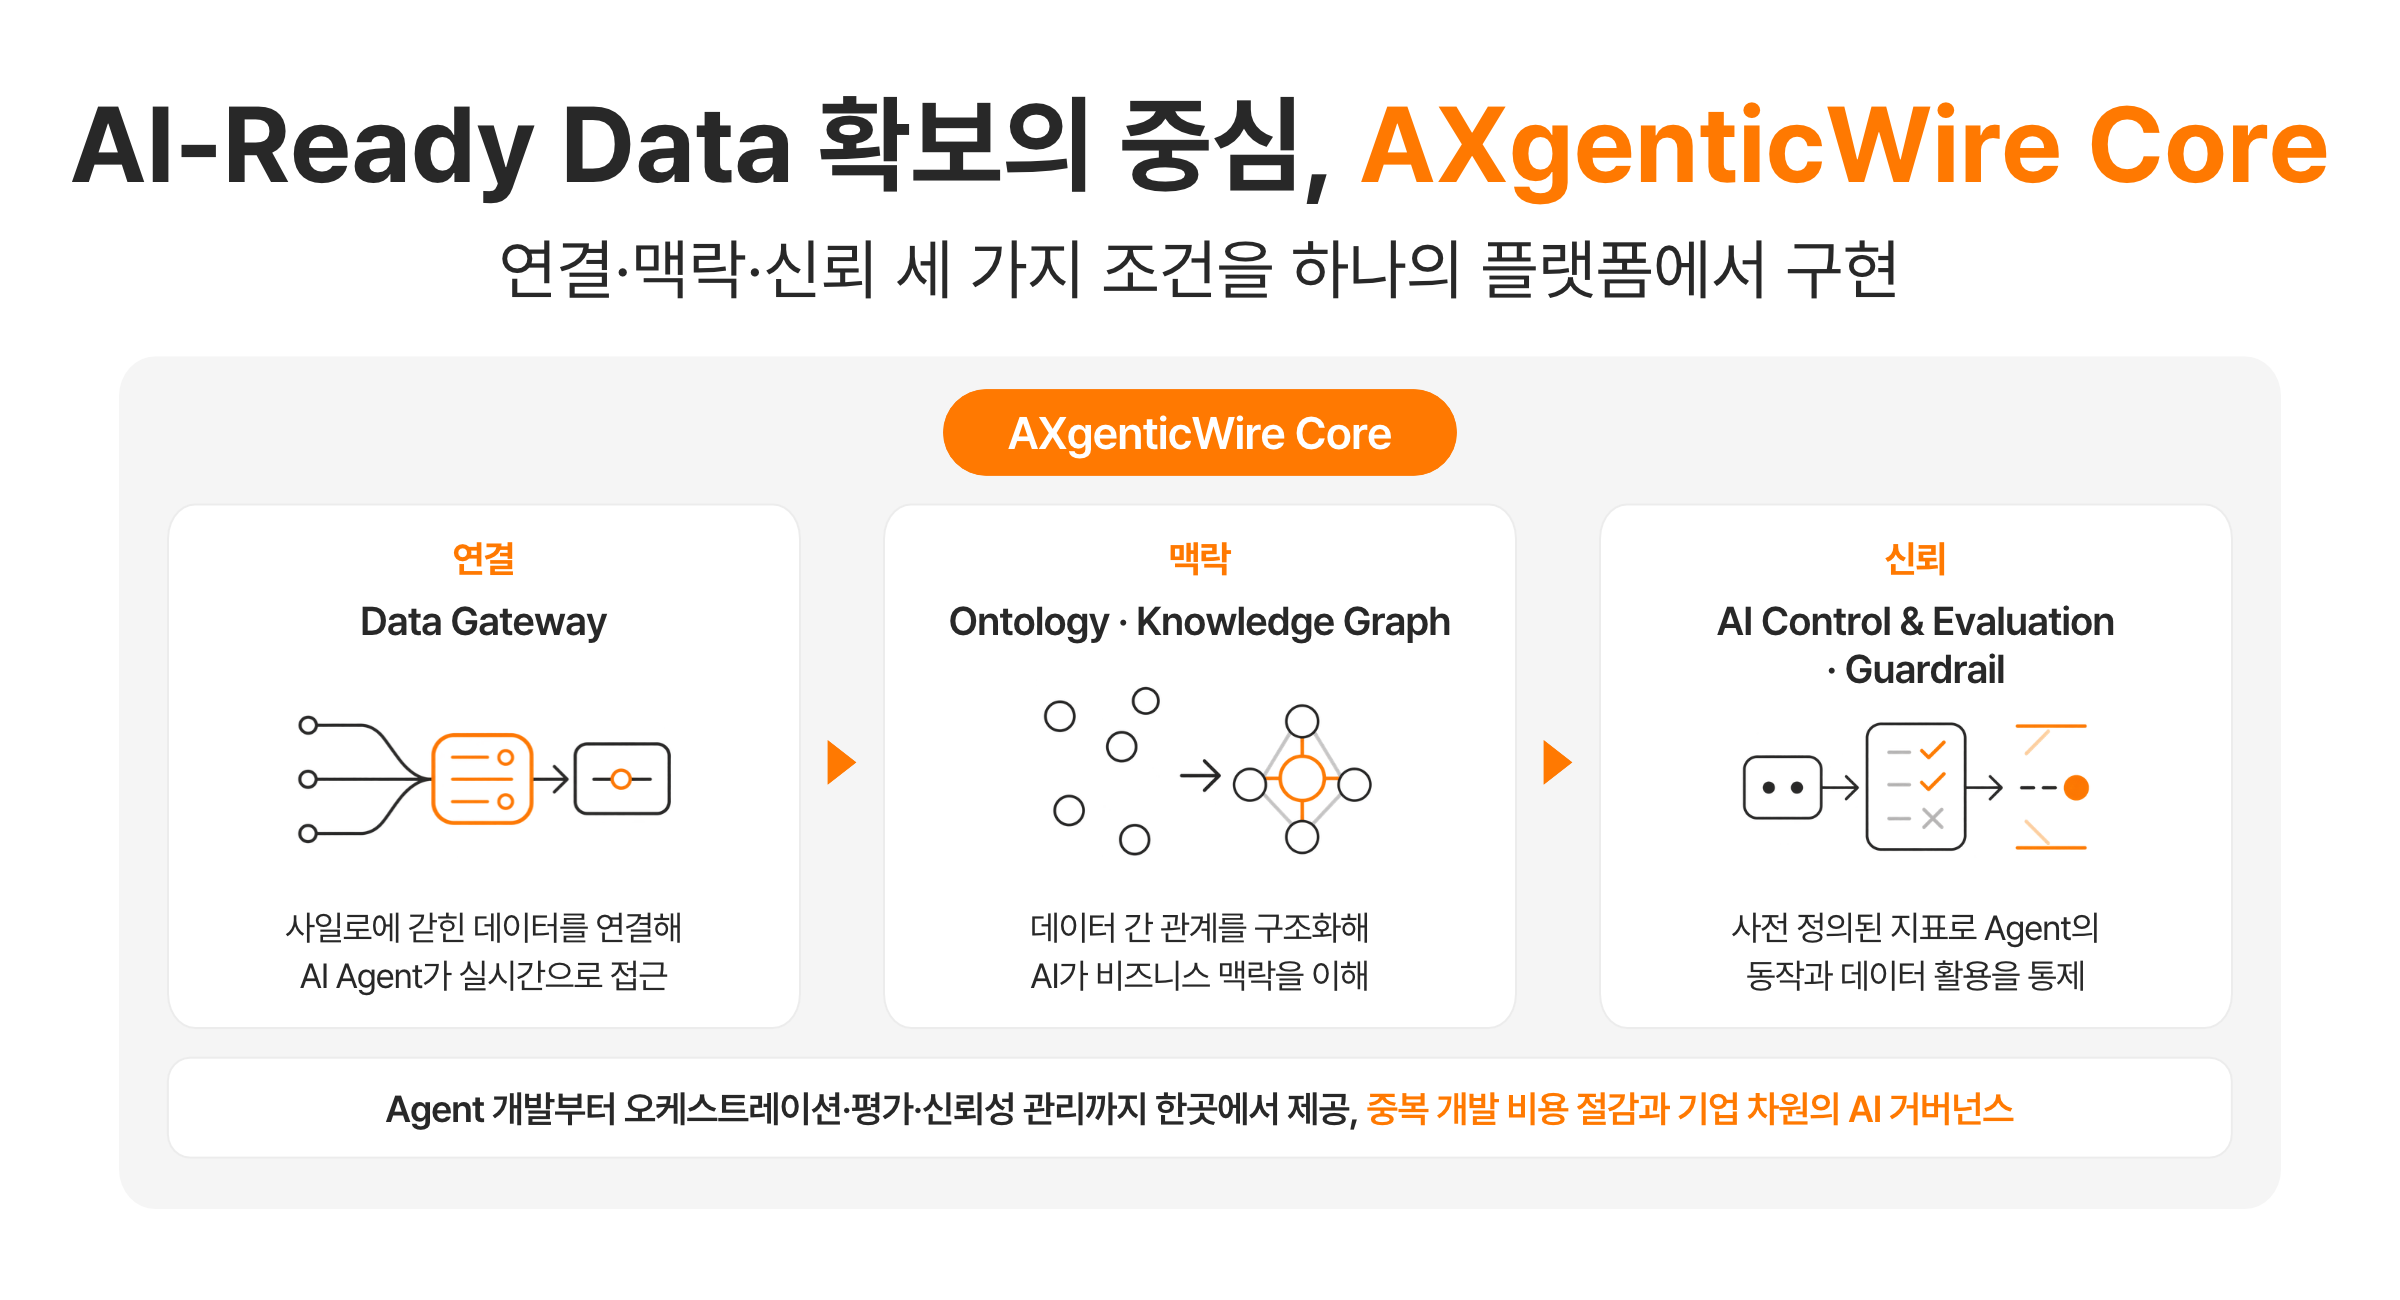
SK AX의 AXgenticWire Core는 이 세 가지 조건을 하나의 플랫폼에서 구현합니다. Core는 범용 LLM 중심의 실험 단계를 넘어, 기업 업무에 바로 적용할 수 있는 Agentic AI 실행 환경을 제공합니다. 출발점은 기업 곳곳에 파편화된 정형·비정형 데이터를 AI Agent가 활용할 수 있도록 재설계하는 것입니다.
연결은 Data Gateway가 맡습니다. 시스템별 사일로에 갇힌 데이터를 연결해 AI Agent가 필요한 정보에 실시간으로 접근하게 합니다. 맥락은 Ontology와 Knowledge Graph가 맡습니다. 데이터 간 관계를 구조화해 AI가 비즈니스 맥락을 이해하도록 돕습니다. 신뢰는 AI Control & Evaluation과 Guardrail이 맡습니다. 사전 정의된 지표를 기반으로 Agent의 동작과 데이터 활용을 정밀하게 통제합니다.
Core는 Agent의 개발부터 오케스트레이션, 평가, 신뢰성 관리까지 한곳에서 제공합니다. 이를 통해 부서마다 Agent를 따로 구축하며 생기는 중복 개발 비용을 줄이고, 기업 차원의 체계적인 AI 거버넌스를 세울 수 있습니다.
AI 시대의 경쟁력은 가장 뛰어난 모델을 확보하는 데 있지 않습니다. AI가 제대로 활용할 수 있는 데이터를 만드는 데서 시작되며, SK AX는 AXgenticWire Core로 그 기반을 함께 만들어갑니다.
[FAQ]
Q1. AI 학습에 웹 데이터보다 책이 주목받는 이유는 무엇인가요?
책에는 편집을 거친 완결된 문장과 일관된 맥락, 체계적인 지식이 담겨 있어 품질이 들쭉날쭉한 웹 데이터보다 학습에 적합합니다. Anthropic도 책을 최고 수준의 LLM을 만드는 가장 비용 효율적인 수단으로 판단해 종이책을 대량 구매했습니다.
Q2. AI-Ready Data란 무엇인가요?
AI가 특정 업무에 바로 활용할 수 있도록 연결되고, 맥락이 구조화되고, 품질과 거버넌스가 관리되는 데이터를 말합니다. SK AX의 AXgenticWire Core는 기업 내 파편화된 정형·비정형 데이터를 AI Agent가 활용할 수 있도록 재설계해 AI-Ready Data 기반을 제공합니다.
Q3. AI-Ready Data가 없으면 AI 프로젝트에 어떤 문제가 생기나요?
AI 프로젝트가 성과를 내지 못하고 중단될 가능성이 커집니다. 가트너는 2026년까지 AI-Ready Data가 뒷받침되지 않는 AI 프로젝트의 60%가 중단될 것으로 전망했습니다.
Q4. 기업이 AI-Ready Data를 확보하려면 무엇부터 해야 하나요?
흩어진 데이터를 연결하고, 데이터 간 관계와 맥락을 구조화하고, 출처와 권한을 관리하는 체계를 갖춰야 합니다. SK AX의 AXgenticWire Core는 Data Gateway로 데이터를 연결하고, Ontology·Knowledge Graph로 맥락을 구조화하며, AI Control & Evaluation·Guardrail로 데이터 활용을 통제해 이 과정을 지원합니다.
AX 컨설팅부터 비즈니스 모델 발굴까지
Global Top 10 AX Service Company|SK AX
#AIReadyData, #AI데이터전략, #기업데이터관리, #데이터사일로, #온톨로지, #지식그래프, #DataGateway, #AI거버넌스, #가트너전망, #Anthropic, #CentralLibrary, #LLM학습데이터, #에이전틱AI, #AXgenticWireCore, #SKAX