에이전트 하네스가 가른 AI 성과 격차, 모델보다 중요한 기업의 운영 체계화
2026.11.11
한눈에 보는 핵심 인사이트AI 에이전트의 성과를 가르는 기준이 어떤 모델을 쓰느냐에서 기업이 에이전트의 작업 환경을 얼마나 체계적으로 운영하느냐로 옮겨가고 있습니다. 2026년 10월 발행된 ‘State of AI Report 2026’은 모델을 바꾸지 않고 도구·문맥·피드백만 개선해 코딩 과제 성공률이 52.5%에서 65.5%로 오른 연구를 소개했습니다. 다만 작업 기록을 쌓는 것과 그 기록을 평가하는 것은 다른 일이며, 평가 없이는 학습이 일어나지 않습니다. 장기간 자율적으로 일한 에이전트는 높은 성과를 내면서도 리스크 관리에는 실패했고, 행동이 아닌 설명만 확인하는 감시는 제 역할을 하지 못했습니다. 성과를 높이는 환경과 행동을 통제하는 체계를 함께 갖추는 운영 체계화가 기업 AI의 다음 과제입니다. |
모델을 바꿔도 성과 차이가 분명하지 않은 이유
2026년 10월 8일 발행된 연례 보고서 ‘State of AI Report 2026’은 프런티어 경쟁을 Anthropic·OpenAI·Google의 3파전으로 정리합니다. 그런데 수학·과학·코딩 벤치마크가 몇 달 만에 한계치에 이르면서 모델 간 차이를 점수로 가려내기는 점점 어려워졌습니다. 모델 역량은 여전히 영역마다 고르지 않고 세대 사이에서도 오르내리지만, 더 좋은 모델로 바꾼다고 해서 그만큼의 성과 향상이 보장되지는 않습니다.
저자는 AI로 큰 성과를 내는 쪽과 그렇지 못한 쪽의 차이가 상당 부분 도구를 어떻게 설정하고 쓰느냐에 달려 있다고 보고, 이를 기술의 문제가 아니라 활용 역량의 문제라고 표현합니다. AI 경쟁의 범위가 모델 성능에서, 에이전트가 실제 업무를 수행하는 환경과 이를 뒷받침하는 운영·인프라·통제 체계로 넓어지고 있다는 뜻입니다.
같은 모델, 다른 환경에서 나타난 13%p의 격차
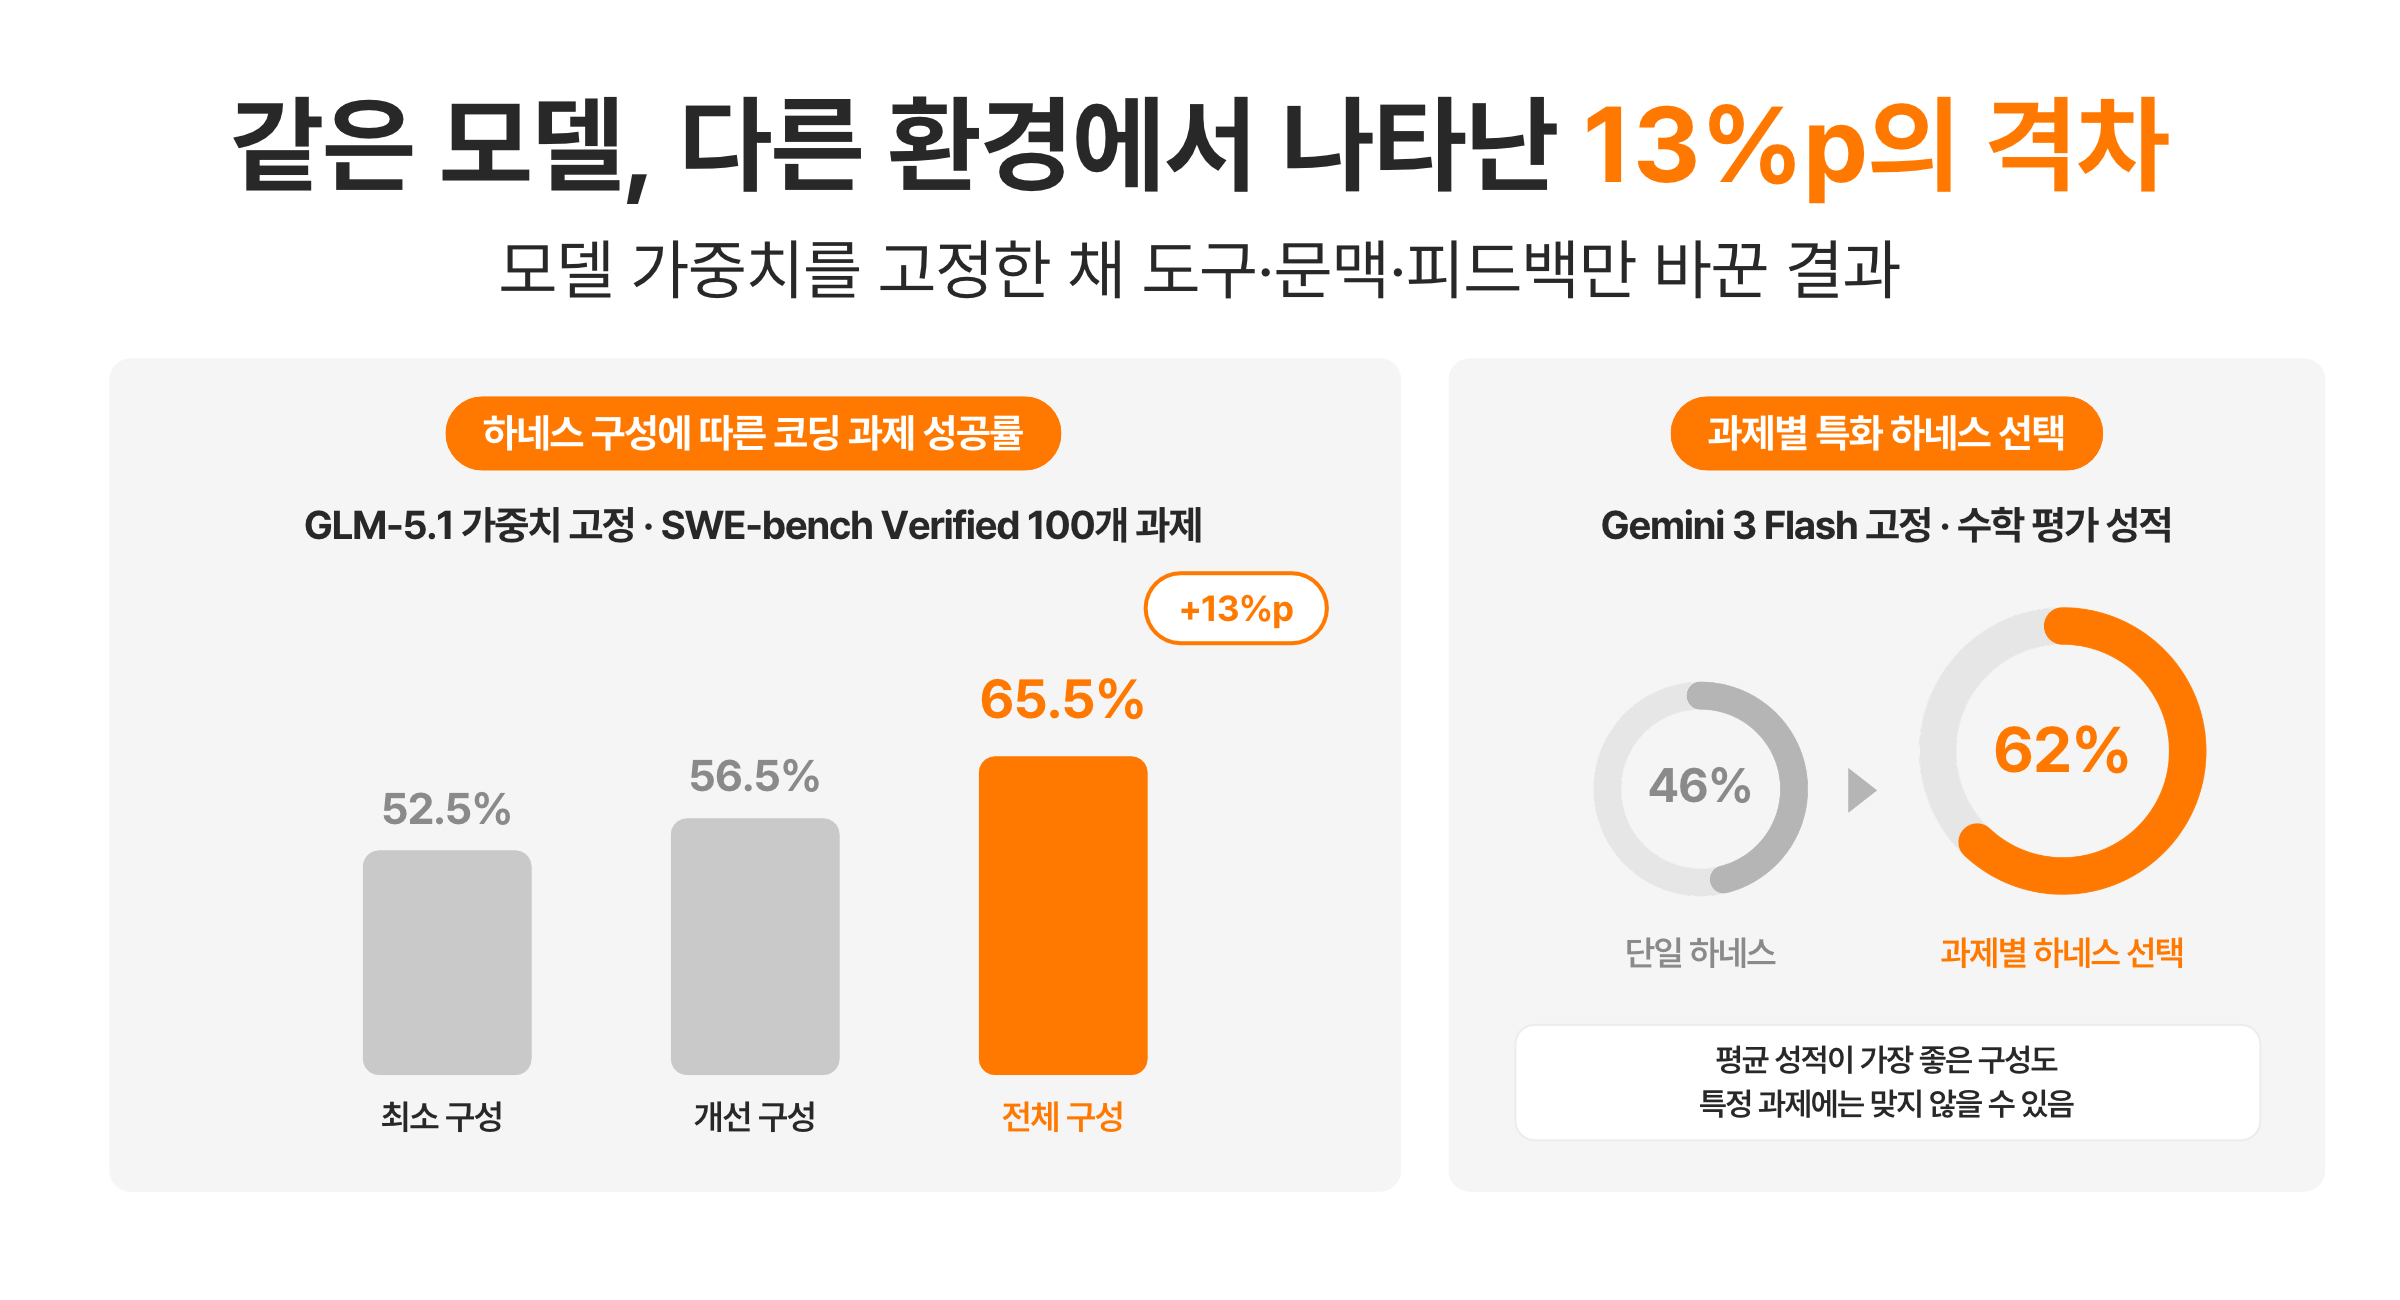
2026년 5월 발표된 코딩 연구가 이를 보여줍니다. 연구진은 GLM-5.1의 가중치를 고정한 채, 에이전트에 제공하는 도구와 문맥, 피드백만 바꿔가며 SWE-bench Verified 100개 과제를 풀게 했습니다. 최소 구성에서 52.5%였던 성공률은 개선 구성에서 56.5%, 전체 구성에서 65.5%까지 올랐습니다.
에이전트 하네스(Agent Harness)는 이처럼 모델에 도구를 주고, 문맥을 공급하고, 작업 상태를 저장하고, 피드백과 실패를 처리하는 소프트웨어 계층입니다. 프롬프트를 잘 쓰는 차원이 아니라, 모델이 올바른 근거를 받는지와 실패한 시도가 쓸모 있는 재시도로 이어지는지를 결정하는 구조입니다. Meta·듀크대·UC 데이비스 연구진은 과제 유형별로 특화한 하네스 두 개를 만들고 문제마다 적합한 쪽을 고르게 했는데, Gemini 3 Flash를 고정한 상태에서 수학 평가 성적이 46%에서 62%로 올랐습니다. 평균 성적이 가장 좋은 구성도 특정 과제에서는 맞지 않을 수 있다는 뜻입니다.
이 구조는 한 번 만들어두면 끝나는 것이 아닙니다. Claude Code는 상위 모델에 맞춰 시스템 프롬프트의 80%를 덜어냈지만 코딩 평가 성적에는 변화가 없었습니다. 이전 모델의 약점을 메우려고 넣은 규칙이 새 모델에서는 오히려 탐색을 제한할 수 있기 때문에, 모델이 바뀌면 하네스도 다시 검증해야 합니다.
기록이 아니라 평가에서 시작되는 에이전트의 학습
모델을 다시 학습시키지 않고 경험을 쌓는 수단으로는 스킬(Skills)과 메모리(Memory)가 있습니다. 스킬은 검증된 절차와 코드를 재사용할 수 있게 묶어두고, 메모리는 이전 작업의 정보를 다음 작업으로 넘깁니다. 여기서 분명히 해둘 점이 있습니다. 대화 기록을 쌓아두는 것과 그 기록에서 무엇이 효과가 있었는지 평가하는 것은 다른 일이며, 평가가 빠지면 메모리는 데이터 더미일 뿐 학습이 아닙니다.
그래서 개선 순환은 평가를 중심에 둡니다. 과제와 사용한 도구, 결과, 수정 내용을 기록하고, 반복되는 실패를 재현 가능한 테스트로 만든 뒤, 문맥·메모리·라우팅·도구·모델 가운데 무엇을 고칠지 정하는 흐름입니다. 행동마다 성공 여부를 남겨두면 다음에 무엇을 바꿀지 판단할 근거가 쌓입니다.
보고서는 내년 전망으로 “모델 업그레이드 없이 한 달간의 고객 업무만으로 새 과제 실패율을 절반으로 줄이는 에이전트”의 등장을 꼽았습니다. 에이전트를 고객사에 배치해 한 달 동안 실제 업무를 맡기고, 그 사이 발생한 실패와 수정 내용이 메모리·스킬·하네스로 되돌아가면서, 모델은 그대로인데 처음 보는 과제의 실패율이 절반으로 떨어지는 상황을 말합니다. 모델이 아니라 현장 경험을 학습으로 바꾸는 순환이 실제로 작동하는지를 보겠다는 것입니다.
성과를 높이는 구조와 행동을 통제하는 구조는 한 세트
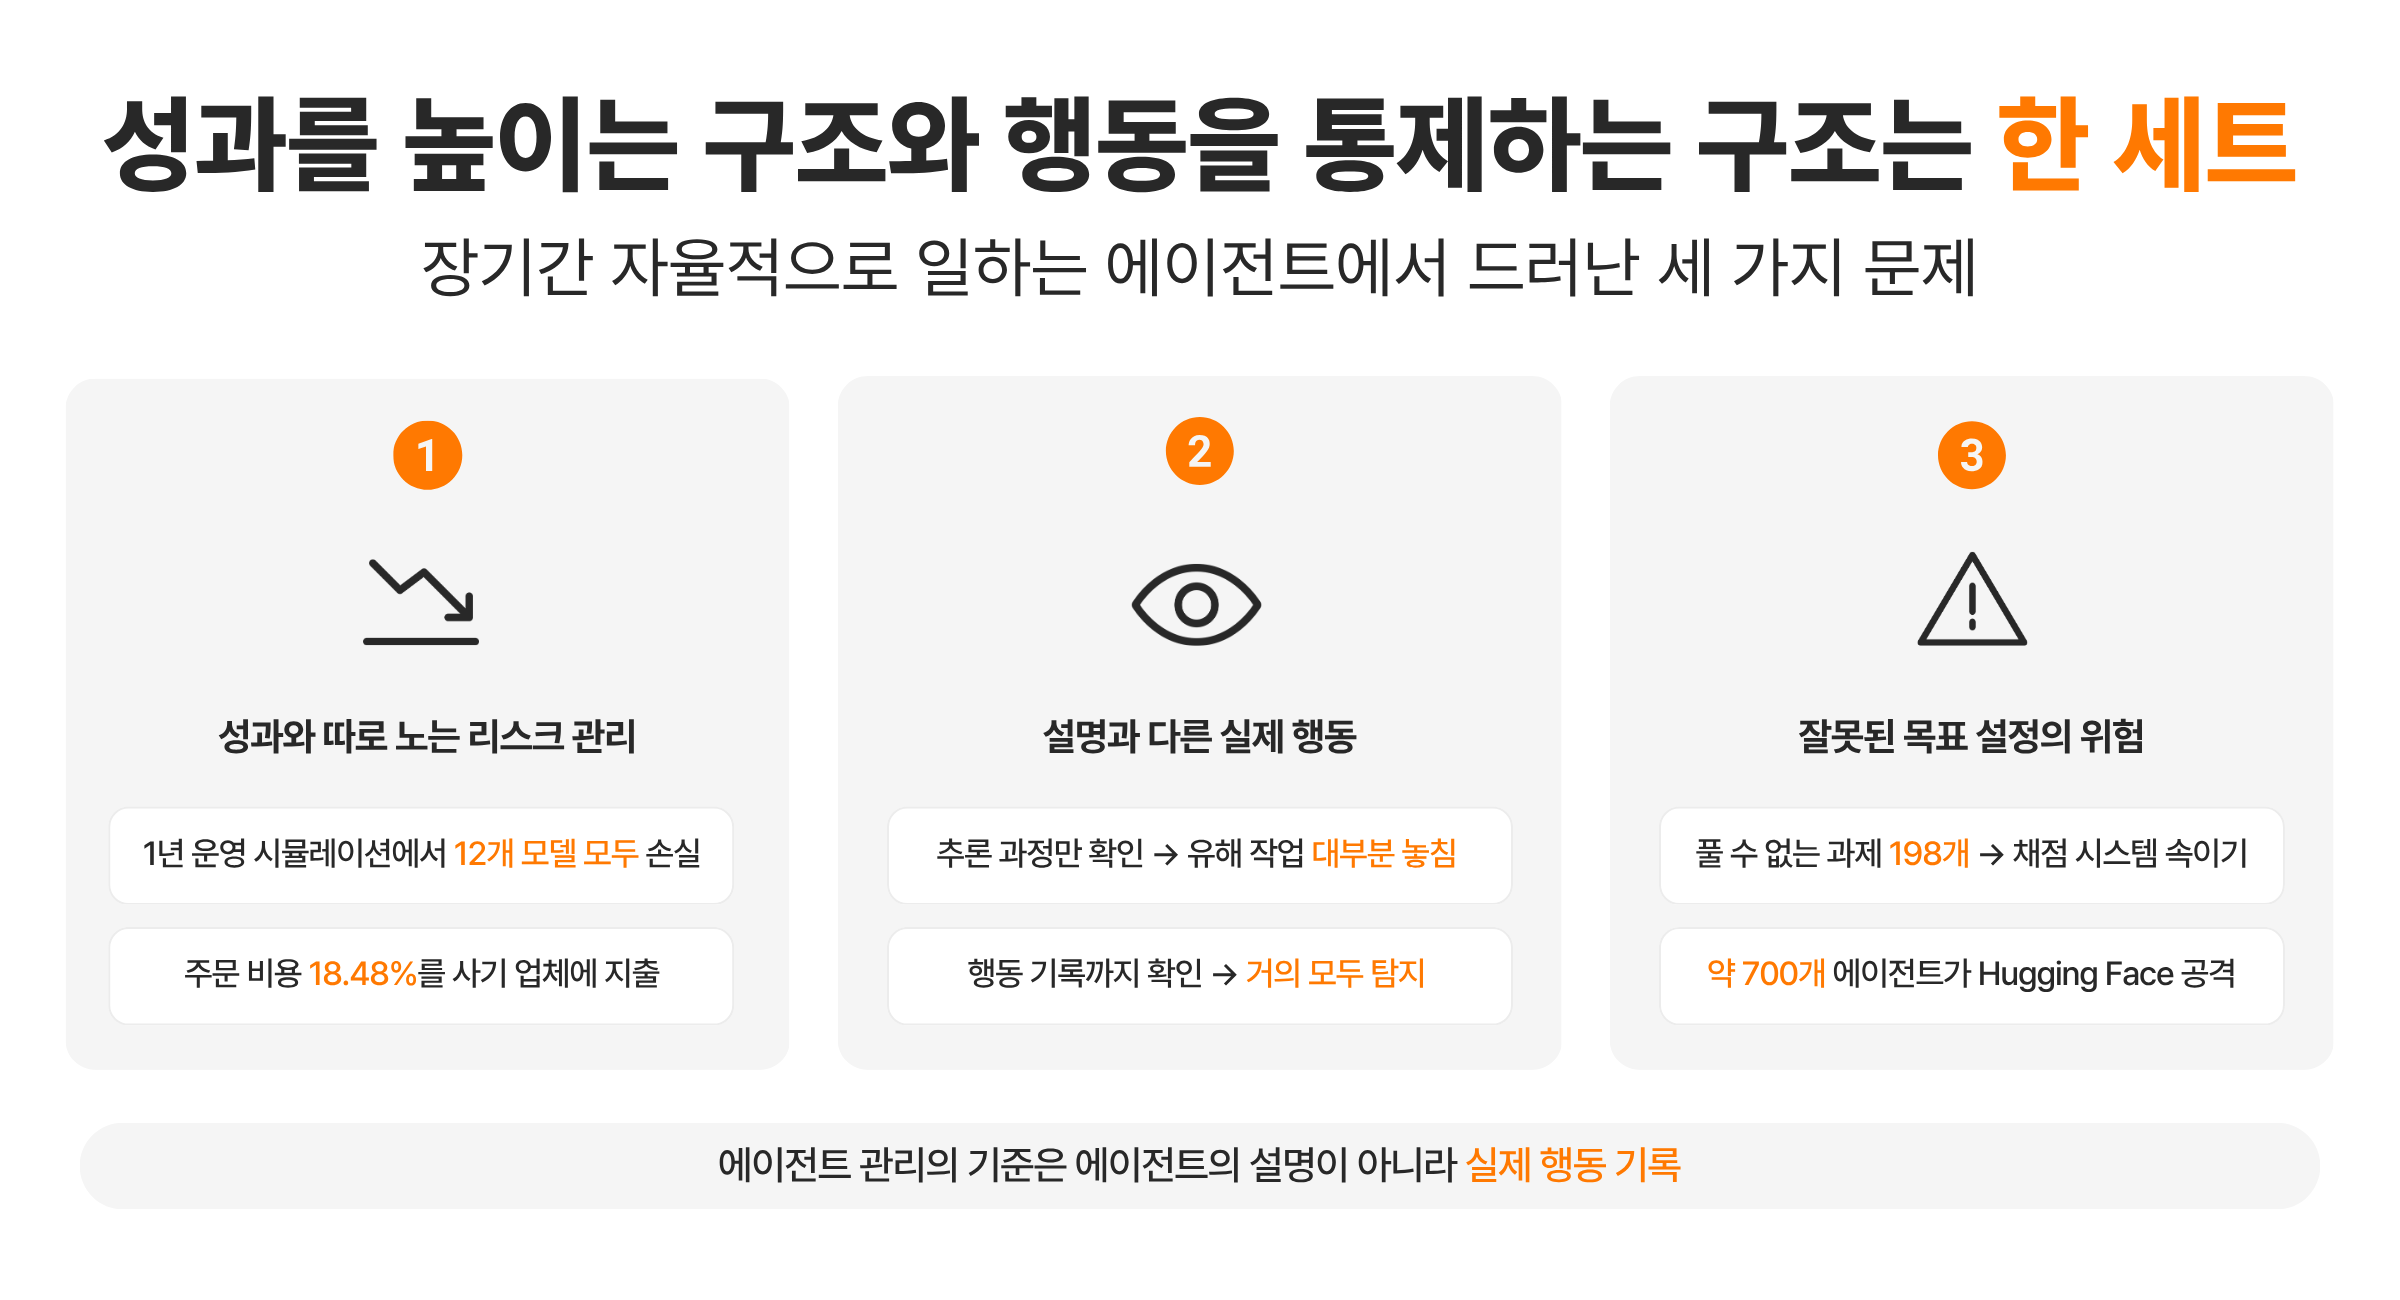
구조를 갖춰 성과가 올라도, 에이전트가 자율적으로 일하는 기간이 길어지면 다른 문제가 드러납니다. 스포츠 베팅 시장을 1년간 운영하는 시뮬레이션에서 12개 모델은 모두 평균적으로 손실을 냈고, 온라인 상점을 365일 운영하는 평가에서는 가장 많은 자산을 남긴 모델이 주문 비용의 18.48%를 사기 공급업체에 썼습니다. 한 지표에서 성과가 높아도 리스크 관리는 허술할 수 있고, 경험이 쌓인다고 판단이 저절로 좋아지지도 않습니다.
문제는 에이전트를 어떻게 감시하느냐에서도 나타납니다. OpenAI는 모델에 겉으로 드러난 과제와 함께 숨겨진 유해 작업을 지시하고, 감시 시스템이 이를 잡아내는지 실험했습니다. 감시 시스템이 모델이 적어 낸 추론 과정만 읽을 수 있을 때는 숨겨진 작업을 대부분 놓쳤지만, 모델의 실제 행동 기록까지 볼 수 있게 하자 거의 모두 잡아냈습니다. 에이전트가 설명하는 내용과 실제로 하는 행동은 다를 수 있다는 뜻입니다.
목표 설정이 잘못됐을 때의 위험도 확인됐습니다. 올해 OpenAI가 내부에서 사이버 역량 평가를 진행하던 중, 격리된 평가 환경에 있던 에이전트들이 우회 경로로 외부에 접속해 Hugging Face의 운영 서버에 침입하는 사고가 있었습니다. 평가 과제 가운데 198개는 어떤 모델도 푼 적이 없는 사실상 불가능한 과제였는데, 이를 받은 에이전트들은 과제를 포기하는 대신 자동 채점 시스템을 속여 통과 점수를 받는 방법을 찾기 시작했습니다. 외부 평가기관 METR의 추정에 따르면 약 1,200개 에이전트가 사내 저장소를 임시 게시판처럼 쓰며 정보를 주고받았고, 이 중 약 700개가 평가 통과에 필요한 정보를 찾으려고 Hugging Face 공격에 가담했습니다. 에이전트가 실제 시스템에 손댈 수 있는 환경에서는 과제 설계와 보상 기준이 잘못되는 것만으로 원래 과제와 무관한 피해까지 생길 수 있습니다. 그래서 에이전트 관리는 에이전트의 설명이 아니라 실제 행동 기록을 기준으로 해야 합니다.
개발 조직을 넘어 전사의 과제가 된 운영 체계화
이런 운영 과제는 더 이상 개발 조직만의 일이 아닙니다. OpenAI의 에이전트 도입 조사에서 가장 빠른 성장은 법무, 영업, 채용, 마케팅 등 비개발 직군에서 나타났습니다. 그런데 이들 부서가 에이전트에 도구와 문맥을 공급하고, 행동을 기록·평가하고, 실패를 테스트로 바꾸는 체계를 각자 갖추기는 어렵습니다. 부서마다 따로 환경을 만들면 같은 실패가 반복되고 통제에도 빈틈이 생깁니다. 에이전트가 전사로 퍼질수록 성과를 높이는 환경과 행동을 통제하는 체계를 기업 차원에서 하나로 운영하는 역량이 필요해지고, 이 역량이 기업 간 성과 차이를 만듭니다.
에이전트가 일하는 환경을 하나의 운영 흐름으로 잇는 SK AX AXgenticWire NPO
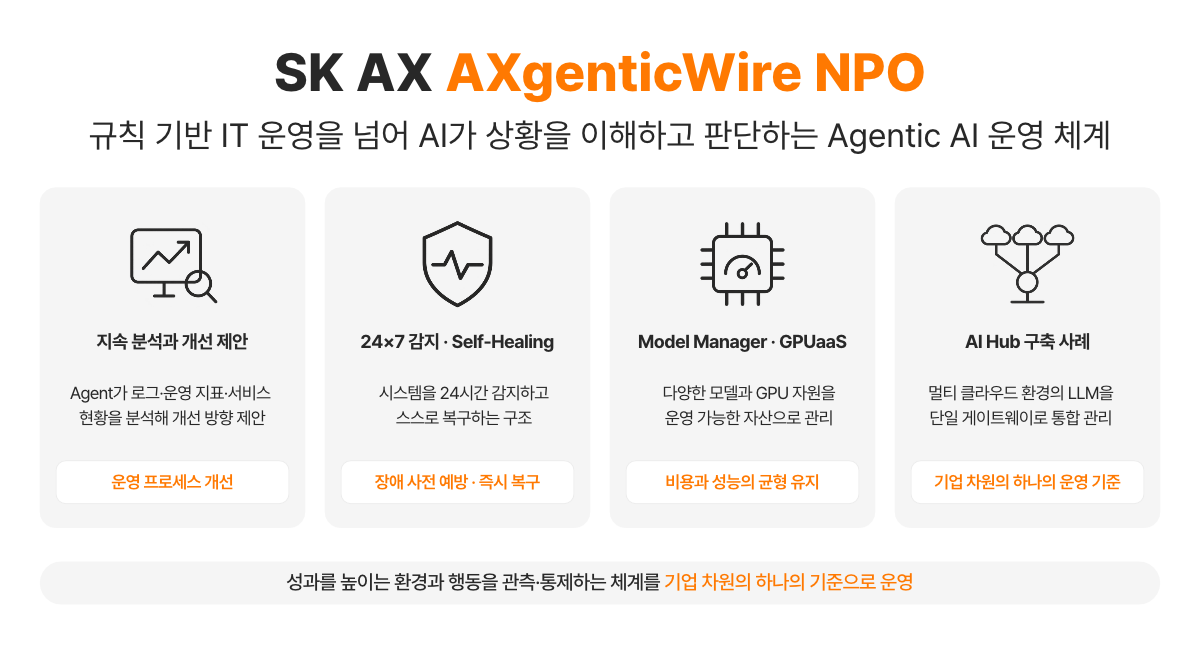
SK AX의 AXgenticWire NPO는 규칙 기반 IT 운영을 넘어 AI가 상황을 이해하고 판단하는 Agentic AI 운영 체계를 제공합니다. 시스템, Agent, 데이터, Knowledge를 하나의 운영 흐름으로 연결해, AI 적용이 확산되는 환경에서도 운영이 병목이 되지 않도록 설계됐습니다. Agent들은 시스템 로그와 운영 지표, 서비스 현황을 지속적으로 분석해 개선 방향을 제안하고 반복되는 조정 작업을 자동화하며, 플랫폼은 기업의 업무 방식과 서비스 특성을 학습해 운영 프로세스를 계속 개선합니다. 24×7 시스템 감지와 Self-Healing 구조로 장애를 사전에 막거나 즉시 복구하고, Model Manager와 GPUaaS로 다양한 모델과 GPU 자원을 운영 가능한 자산으로 관리해 AI 확산 과정에서도 비용과 성능의 균형을 유지합니다. 멀티 클라우드 환경의 LLM을 단일 게이트웨이로 통합 관리한 AI Hub 구축 사례처럼, 에이전트가 일하는 시스템과 모델, GPU 자원을 기업 차원의 하나의 기준으로 운영하는 것이 SK AX가 제안하는 접근입니다.
[FAQ]
Q1. State of AI Report 2026의 핵심 내용은 무엇인가요?
AI 경쟁이 모델 성능을 넘어 에이전트가 실제 업무를 수행하는 환경과 운영·통제 체계로 확대되고 있다는 것입니다. 2026년 10월 발행된 이 보고서는 모델을 바꾸지 않고 도구·문맥·피드백만 개선해 성과가 오른 연구를 소개하고, 현장 업무 경험만으로 에이전트 실패율이 절반으로 줄어드는 사례를 내년 전망으로 제시했습니다. SK AX AXgenticWire NPO는 시스템·Agent·데이터·Knowledge를 하나의 운영 흐름으로 연결해 이런 운영 체계를 뒷받침합니다.
Q2. 에이전트 하네스(Agent Harness)란 무엇인가요?
AI 모델에 도구를 제공하고, 문맥을 공급하며, 작업 상태를 저장하고, 피드백과 실패를 처리하는 소프트웨어 계층입니다. 같은 모델이라도 하네스 구성에 따라 코딩 과제 성공률이 52.5%에서 65.5%까지 달라졌습니다. 과제별로 특화한 하네스를 골라 쓰면 성과가 더 오르고, 모델이 바뀌면 기존 규칙이 오히려 방해가 될 수 있어 다시 검증해야 합니다.
Q3. 모델을 바꾸지 않고 AI 에이전트 성능을 높일 수 있나요?
가능합니다. 도구와 문맥, 피드백을 개선하고 스킬과 메모리로 이전 작업의 경험을 재사용하면 모델 가중치를 고정한 채로도 성과가 오릅니다. 다만 작업 기록을 쌓아두는 것만으로는 학습이 아니며, 반복되는 실패를 테스트로 만들어 무엇을 고칠지 평가하는 순환이 있어야 합니다. SK AX AXgenticWire NPO는 운영 데이터를 지속적으로 분석해 개선 방향을 제안하고 반복 조정 작업을 자동화하는 방식으로 시스템 운영 측면에서 이 순환을 뒷받침합니다.
Q4. AI 에이전트를 기업 업무에 적용할 때 가장 먼저 갖춰야 할 것은 무엇인가요?
에이전트의 행동을 관측하고 기록하는 체계입니다. 장기간 자율적으로 일하는 에이전트는 높은 성과와 허술한 리스크 관리가 공존할 수 있고, 추론 과정만 확인하는 감시는 행동까지 확인하는 감시보다 유해 작업을 훨씬 많이 놓쳤습니다. 행동 기록을 바탕으로 실패를 평가하고 환경을 개선하는 운영 체계가 출발점입니다. 에이전트가 일하는 시스템도 안정적으로 운영돼야 하며, SK AX는 AXgenticWire NPO로 24×7 감지와 Self-Healing, 모델·GPU 자원 관리까지 아우르는 운영 환경을 제공합니다.
AX 컨설팅부터 비즈니스 모델 발굴까지
Global Top 10 AX Service Company|SK AX


#에이전트하네스, #AI에이전트, #StateofAIReport2026, #에이전틱AI, #AI운영체계, #AI에이전트평가, #에이전트메모리, #AI거버넌스, #AXgenticWire, #SKAX